


Doanh nghiệp càng phát triển càng có nhiều thông tin, tuy nhiên chúng thường nằm rải rác ở website, Excel, catalogue, Google Drive, Sales, Customer Service và hệ thống AI. Khi các nguồn không được đồng bộ, cùng một câu hỏi có thể nhận nhiều câu trả lời khác nhau. Website nói bảo hành 12 tháng, file mới ghi 18 tháng, Sales nhớ 24 tháng, vì vậy AI không biết đâu là thông tin hiện hành.
Đây không chỉ là vấn đề Content mà là vấn đề quản trị tri thức.
Vì vậy, doanh nghiệp cần Single Source of Truth – một nguồn thông tin chuẩn được xác định rõ ràng cho từng loại dữ liệu quan trọng, để mọi kênh cùng dựa trên một nguồn đáng tin cậy.
1. Doanh nghiệp không thiếu thông tin, doanh nghiệp có thể có quá nhiều phiên bản của cùng một thông tin
Ví dụ, một công ty phần mềm B2B có gói Standard từng hỗ trợ 10 tài khoản, sau đó được nâng lên 20 tài khoản. Product Team và Sales đã cập nhật, nhưng:
● Landing Page cũ vẫn ghi 10 tài khoản;
● Bài Blog cũ vẫn ghi 10;
● File PDF lại ghi 15 do từng được thử nghiệm.
Khách hàng có thể đọc một con số trên Google nhưng lại nhận được con số khác khi hỏi Sales. Điều này cho thấy, sự thiếu nhất quán của Content bắt đầu ảnh hưởng trực tiếp đến Trust.
2. Vấn đề không nằm ở một bài viết sai
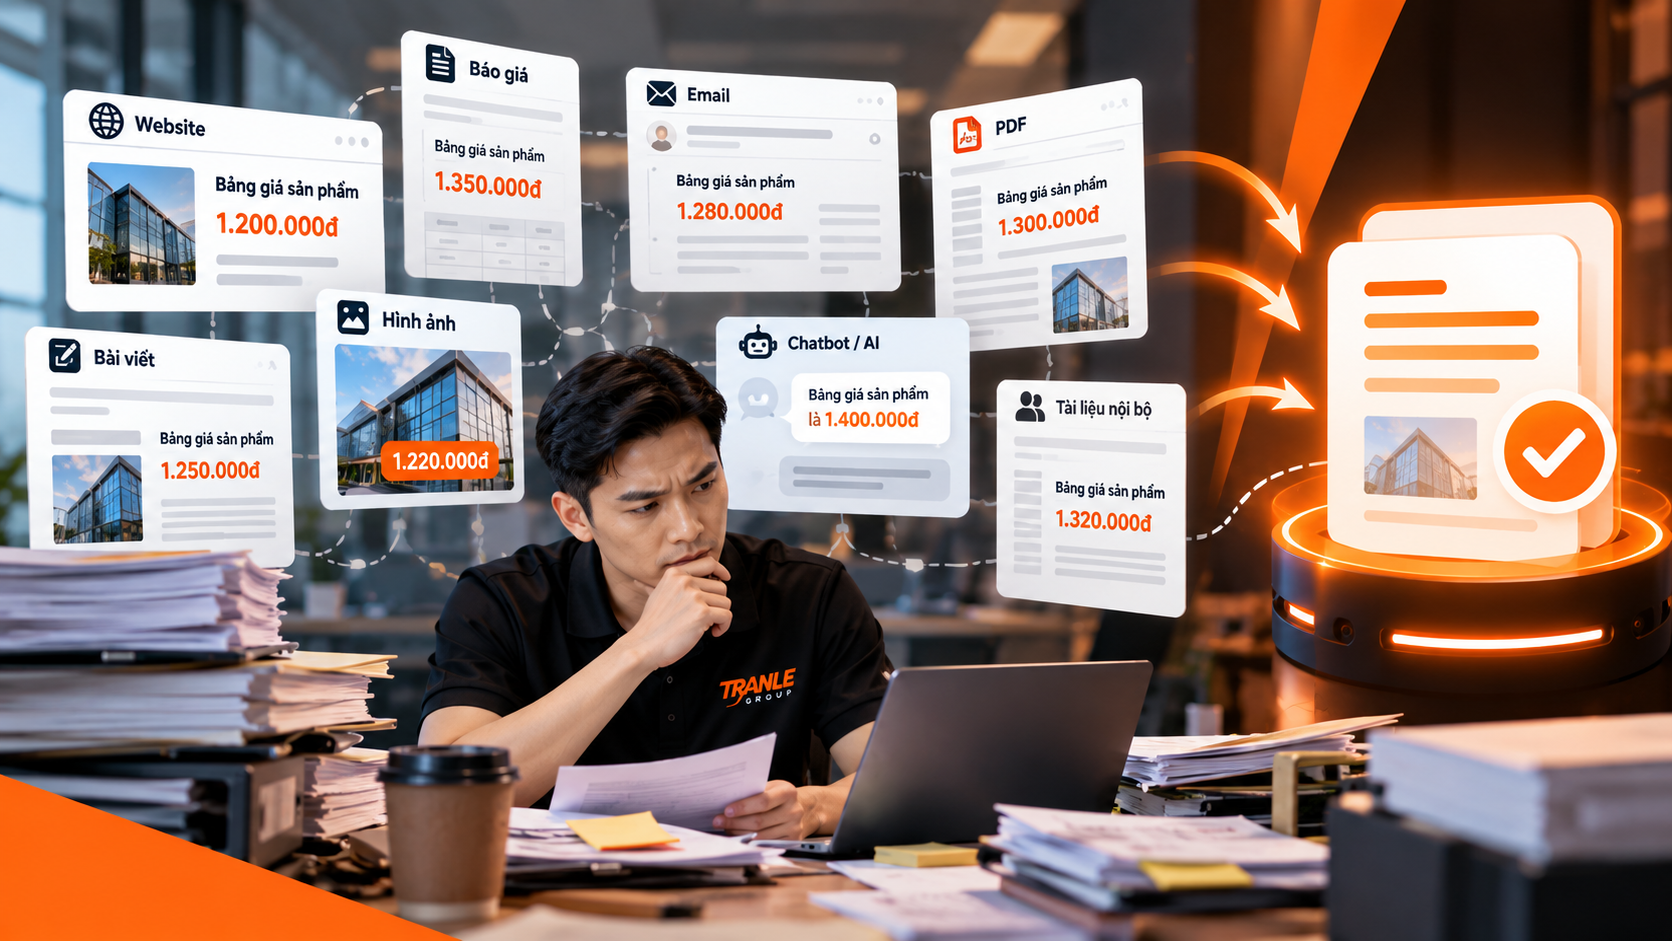
Nếu chỉ có một bài sai, việc chỉnh sửa sẽ rất dễ dàng. Nhưng với 5.000 URL, 200 tài liệu, hàng chục Landing Page,… thì vấn đề lớn hơn là: Thông tin chuẩn nằm ở đâu? Nếu không xác định được nguồn chuẩn, việc cập nhật Content sẽ phải tiến hành thủ công từng nơi, rất dễ bỏ sót.
3. Single Source of Truth không có nghĩa mọi dữ liệu phải nằm trong một file
Đây là một trong những hiểu nhầm rất phổ biến. Single Source of Truth không có nghĩa là toàn bộ doanh nghiệp phải dùng chung một Database.
Mỗi loại dữ liệu có thể có nguồn chuẩn riêng:
Giá sản phẩm → ERP
Thông số kỹ thuật → Product Database
Thông tin khách hàng → CRM
Knowledge → Knowledge Base
Content → CMS
Điều quan trọng là doanh nghiệp phải xác định rõ: Với mỗi loại thông tin, đâu là nguồn có thẩm quyền cao nhất?
4. Source of Truth là vấn đề về Authority
Giả sử giá sản phẩm được ghi khác nhau ở ba nơi:
• Website: 12 triệu
• PDF: 11,5 triệu
• ERP: 12,8 triệu
Vậy, vấn đề quan trọng cần xác định là: Nguồn nào là Authority? Nếu ERP là nguồn giá chuẩn, các hệ thống khác cần tham chiếu hoặc đồng bộ từ ERP. Khi đó: ERP → Website → Sales → AI, thay vì mỗi hệ thống tự duy trì một mức giá khác nhau.
5. Đây là khác biệt giữa “Copy Data” và “Reference Data”
Copy Data là mô hình rất dễ gây lỗi. Có thể hình dung mô hình này như sau: Giá gốc → Website → PDF → Sales → AI Knowledge Base.
Với mô hình này, khi giá thay đổi, doanh nghiệp sẽ phải cập nhật ở nhiều nơi. Chỉ cần bỏ sót một nơi là các nguồn thông tin sẽ inconsisten (không đồng nhất).
Thay vì vậy, doanh nghiệp nên áp dụng mô hình: Xác định Master Data và để các hệ thống khác tham chiếu hoặc được cập nhật từ đó. Lúc này, doanh nghiệp chỉ cần quản lý dữ liệu chuẩn tại một nguồn thay vì cập nhật thủ công nhiều nơi.
6. Content cũng cần Source of Truth
Source of Truth không chỉ áp dụng cho giá mà còn áp dụng cho nhiều thông tin quan trọng khác. Ví dụ, chính sách bảo hành có thể được sử dụng trên nhiều kênh như:
● Product Page;
● FAQ;
● Blog;
● Báo giá;
● Tài liệu Sales.
Thay vì quản lý từng nội dung riêng lẻ, doanh nghiệp nên xem Warranty Policy (Chính sách bảo hành) là một Knowledge Object (Đối tượng tri thức), trong đó xác định rõ:
• Current Value (Giá trị hiện tại)
• Effective Date (Ngày có hiệu lực)
• Owner (Người/Bộ phận chịu trách nhiệm)
• Version (Phiên bản)
• Source (Nguồn thông tin)
Các nội dung khác khi sử dụng chính sách bảo hành sẽ tham chiếu đến Knowledge Object này, thay vì tự lưu một phiên bản thông tin riêng.
7. Đây là lúc Content bắt đầu chuyển từ “Document” sang “Structured Knowledge”
*Structured Knowledge (Tri thức có cấu trúc): là cách tổ chức thông tin thành các trường dữ liệu và mối quan hệ rõ ràng, thay vì chỉ lưu dưới dạng văn bản.
Theo cách truyền thống, thông tin nằm trong một khối văn bản, ví dụ: “Sản phẩm được bảo hành 18 tháng.” Khi đó, 18 tháng chỉ là một phần của câu văn, không phải một trường dữ liệu riêng, nên hệ thống khó quản lý, cập nhật và đồng bộ khi thông tin thay đổi.
Khi được cấu trúc thành:
• Product: A
• Warranty: 18 months
• Effective Date: 01/09/2026
• Status: Active
thông tin trở thành Structured Knowledge, giúp hệ thống dễ quản lý, cập nhật và sử dụng hơn.
8. Structured Knowledge đặc biệt quan trọng khi website lớn
Website 50 bài có thể cập nhật thủ công, nhưng 10.000 URL thì khác.
Ví dụ, doanh nghiệp đổi thời gian bảo hành từ 12 tháng thành 18 tháng. Nếu thông tin này xuất hiện trên 87 URL, Content Team phải tìm và cập nhật từng nơi.
Nhưng nếu hệ thống xác định được Relationship (mối quan hệ) giữa Warranty Policy (chính sách bảo hành) và các nội dung liên quan:
Warranty Policy (Chính sách bảo hành)
→ Được sử dụng trong URL A
→ Được sử dụng trong URL B
→ Được sử dụng trong URL C
thì khi chính sách thay đổi, doanh nghiệp có thể nhanh chóng xác định những URL cần cập nhật và kiểm tra, giúp việc kiểm tra, rà soát trở nên dễ dàng và chính xác hơn.
9. Knowledge Graph và Single Source of Truth bổ sung cho nhau
Knowledge Graph trả lời cho câu hỏi: Thông tin nào liên quan đến thông tin nào? Còn Single Source of Truth (Nguồn thông tin chuẩn duy nhất) trả lời cho câu hỏi: Trong số các nguồn đó, đâu là thông tin chuẩn?
Hai hệ thống kết hợp với nhau theo logic:
Entity (Thực thể) → Relationship (Mối quan hệ) → Knowledge Object (Đối tượng tri thức) → Authoritative Source (Nguồn có thẩm quyền).
Nhờ đó, doanh nghiệp vừa kết nối được tri thức, vừa xác định được nguồn thông tin chuẩn — nền tảng quan trọng để đưa AI vào hoạt động thực tế.
10. AI làm vấn đề “nhiều phiên bản sự thật” trở nên rõ hơn
Con người đôi khi biết: “File này cũ rồi, đừng dùng”, nhưng AI không tự biết điều đó.
Ví dụ, Knowledge Base có:
• File A – 2022: Bảo hành 12 tháng.
• File B – 2024: Bảo hành 18 tháng.
• File C – 2026: Bảo hành 24 tháng.
AI có thể đọc cả ba. Nếu Metadata (Siêu dữ liệu) không rõ ràng, AI có thể chọn nhầm phiên bản và đưa ra thông tin không còn chính xác.
11. AI tốt không chỉ cần nhiều dữ liệu
Nhiều người thường cho rằng, muốn AI hiểu doanh nghiệp thì đưa càng nhiều tài liệu vào càng tốt. Tuy nhiên không hẳn vậy.
Nếu đưa vào:
● Dữ liệu cũ;
● Dữ liệu trùng;
● Dữ liệu mâu thuẫn;
● Tài liệu không rõ phiên bản;
AI có thể có nhiều Context (Ngữ cảnh) hơn, nhưng chưa chắc có Context tốt hơn. Có thể hiểu đơn giản: More Data ≠ Better Knowledge.
Điều quan trọng hơn là:
• Trusted Data (Dữ liệu đáng tin cậy)
• Current Data (Dữ liệu hiện hành)
• Structured Data (Dữ liệu có cấu trúc)
• Context (Ngữ cảnh đầy đủ).
12. Hãy lấy một ví dụ khác: doanh nghiệp thiết bị y tế
Doanh nghiệp có thể quản lý nhiều model, thông số, phụ kiện, tài liệu và hướng dẫn. Khi nhà sản xuất thay đổi thông số nhưng website vẫn dùng catalogue cũ, content có thể gây nhầm lẫn.
Vì vậy, Source of Truth nên là tài liệu kỹ thuật chính thức của model hiện hành, đã được bộ phận phụ trách xác nhận. Website không nên tự “sáng tạo” thông số. Về phía Content Writer cũng cần phân biệt rõ: Dữ liệu được phép diễn đạt linh hoạt và dữ liệu phải lấy chính xác từ nguồn chuẩn.
13. Không phải mọi Knowledge đều có cùng mức độ Authority
Doanh nghiệp có thể phân loại Knowledge theo mức độ tin cậy:
Level 1 – Verified Fact (Thông tin đã xác minh)
Ví dụ: Kích thước, giá, chính sách, thông số.
Cần có nguồn xác nhận rõ ràng.
Level 2 – Expert Knowledge (Kiến thức chuyên gia)
Ví dụ: Đề xuất xử lý của kỹ thuật viên.
Có thể cần chuyên gia kiểm tra.
Level 3 – Experience (Kinh nghiệm thực tế)
Ví dụ: Một tình huống thường gặp trong các dự án thực tế.
Level 4 – Hypothesis (Giả thuyết)
Ví dụ: Một xu hướng doanh nghiệp nhận thấy nhưng chưa được xác nhận.
Việc phân biệt rõ các cấp độ sẽ giúp AI và Content Team sử dụng thông tin đúng mức độ tin cậy.
14. Đây cũng là cách tránh biến suy luận thành sự thật
Trong quá trình tạo Content rất dễ xảy ra tình trạng: một Observation (Quan sát) có thể qua Interpretation (Diễn giải) rồi được AI viết lại thành một Fact (Sự thật).
Ví dụ, Sales nói: “Gần đây khách có vẻ thích model B hơn”, nhưng AI viết: “Model B hiện là lựa chọn phổ biến nhất của khách hàng.”
Mức độ khẳng định của 2 câu hoàn toàn khác nhau: câu đầu là quan sát, câu sau là một khẳng định cần dữ liệu chứng minh. Vì vậy, Knowledge Governance cần giữ rõ ranh giới giữa quan sát, diễn giải và sự thật đã được xác minh.
15. Source cần đi cùng Provenance
Provenance trả lời câu hỏi: “Thông tin này đến từ đâu?”
Ví dụ, với dữ liệu: “62% khách chọn phương án A”, doanh nghiệp cần ghi rõ:
● Khảo sát nào;
● Bao nhiêu khách;
● Thời gian nào;
● Bộ phận nào thực hiện.
Nhờ vậy, doanh nghiệp vẫn có thể kiểm tra và đánh giá độ tin cậy của dữ liệu sau nhiều năm.
16. Freshness (tính cập nhật) cũng là một thuộc tính của Knowledge
Không phải thông tin nào cũng giữ nguyên mãi. Ví dụ: Giá, số lượng cửa hàng, tính năng phần mềm và chính sách có thể thay đổi thường xuyên, còn lịch sử thành lập doanh nghiệp thì không. Vì vậy, mỗi Knowledge Object cần ghi rõ:
• Created Date (Ngày tạo)
• Last Verified (Lần xác minh gần nhất)
• Review Frequency (Tần suất rà soát)
• Owner (Người/Bộ phận phụ trách).
Nhờ đó, doanh nghiệp biết thông tin nào còn hiệu lực, khi nào cần rà soát và ai chịu trách nhiệm cập nhật.
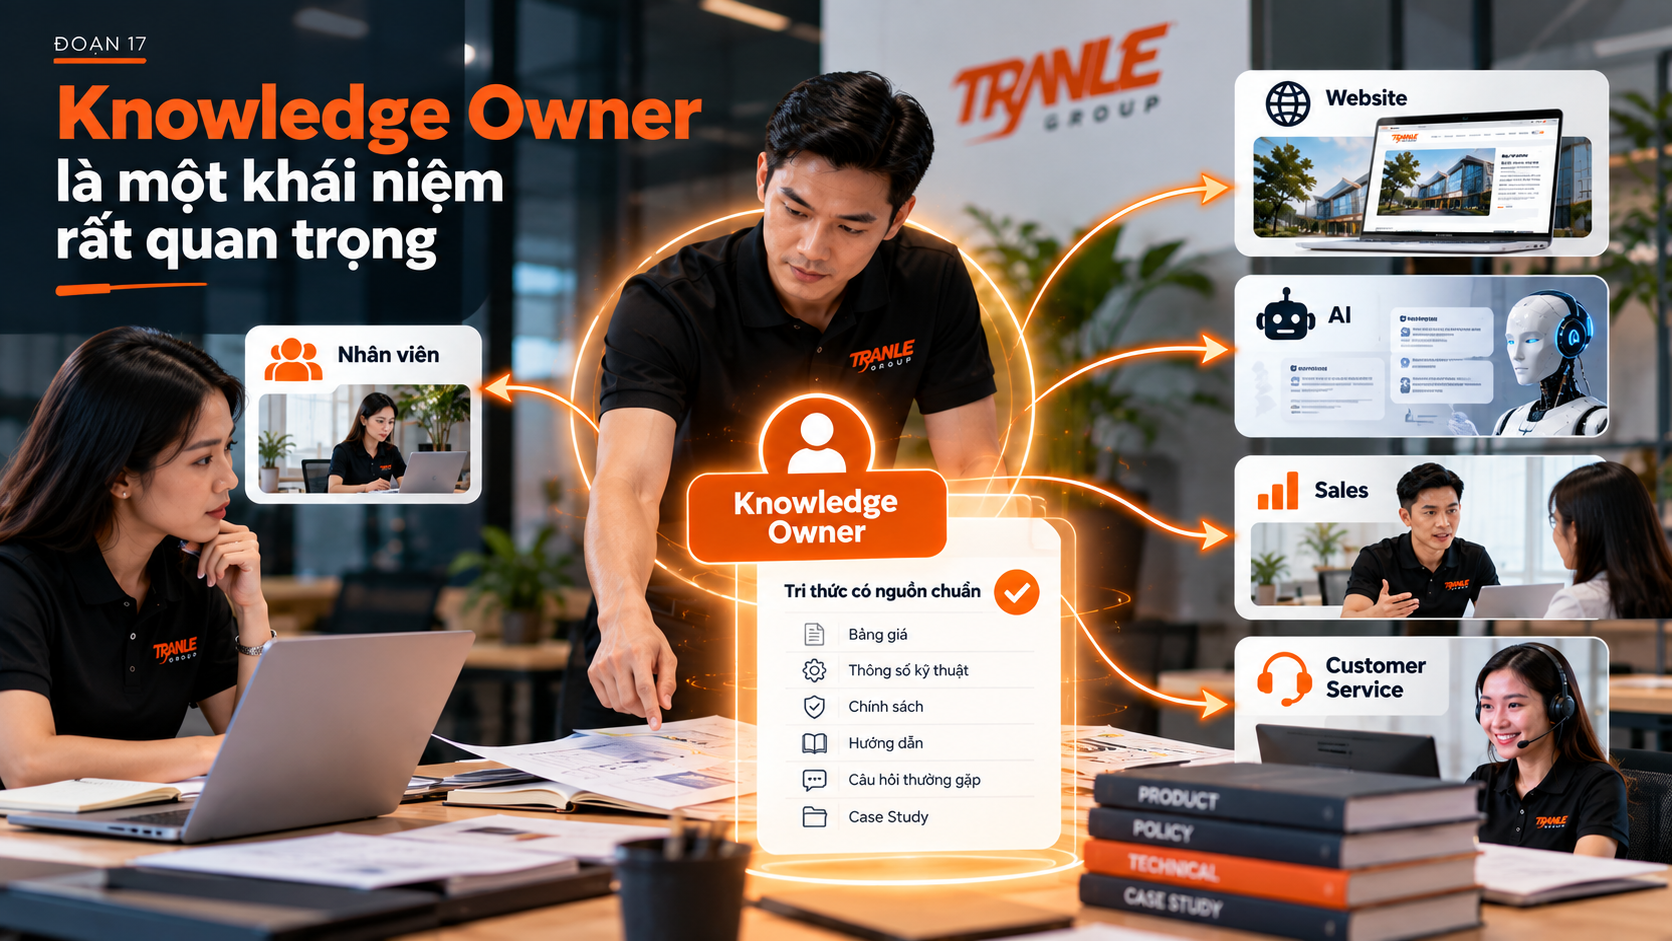
17. Knowledge Owner là một khái niệm rất quan trọng
Knowledge Owner (Người/Bộ phận phụ trách tri thức) là người chịu trách nhiệm xác nhận thông tin.
Ví dụ:
Bảng giá → Sales Manager
Thông số kỹ thuật → Technical Manager
Chính sách bảo hành → Operations
Content Team không nên là nơi quyết định mọi thông tin của doanh nghiệp, họ chủ yếu trình bày và chuyển hóa tri thức thành Content, còn việc xác nhận tri thức nên thuộc về Knowledge Owner.
18. Đây là nền tảng của Content Governance (Quản trị nội dung)
Khi website còn nhỏ, quy trình đơn giản là: Writer viết → Editor kiểm tra → Đăng.
Nhưng khi lượng tài sản số của doanh nghiệp ngày càng lớn và phức tạp hơn, quy trình có thể mở rộng thành: Knowledge Source (Nguồn tri thức) → Owner (Người/Bộ phận phụ trách) → Validation (Xác nhận) → Content (Nội dung) → Publication (Xuất bản) → Monitoring (Theo dõi) → Refresh (Cập nhật).
Đây chính là Content Governance - giúp doanh nghiệp kiểm soát nguồn thông tin, người chịu trách nhiệm và quá trình cập nhật nội dung.
19. Content Governance không phải để làm quy trình phức tạp hơn
Mục tiêu không phải tạo thêm thủ tục, mà là hạn chế:
● Sai thông tin;
● Nội dung mâu thuẫn;
● Bài lỗi thời;
● Tri thức trùng lặp;
● AI tạo thông tin sai dựa trên dữ liệu nội bộ không chính xác.
Doanh nghiệp SME có thể bắt đầu đơn giản, với những quy tắc phù hợp với quy mô thực tế.
20. Ví dụ một Knowledge Registry nhỏ
Doanh nghiệp có thể bắt đầu bằng một bảng đơn giản:
| Knowledge (Tri thức) | Source (Nguồn) | Owner (Phụ trách) | Updated (Cập nhật) | Status (Trạng thái) |
| Bảng giá | ERP | Sales | 09/2026 | Active |
| Bảo hành | Policy DB | Operations | 08/2026 | Active |
| Thông số SP A | Product DB | Technical | 09/2026 | Active |
| Chính sách cũ | Document 2024 | Operations | 2024 | Archived |
Chỉ cần xác định rõ thông tin nào còn hiệu lực, nguồn nào là chuẩn và ai chịu trách nhiệm, doanh nghiệp đã có thể giảm đáng kể tình trạng nhầm lẫn giữa các phiên bản.
21. Website cũng cần biết nội dung nào là Canonical Knowledge
Canonical Knowledge (tri thức chuẩn) không chỉ có ý nghĩa trong kỹ thuật SEO. Ở đây, khái niệm này được mở rộng từ SEO sang quản trị tri thức. Doanh nghiệp cần xác định: URL nào là nguồn chính để giải thích một chủ đề?
Ví dụ:
Topic: Chính sách bảo hành → Canonical Knowledge Page: Trang chính sách bảo hành.
Các bài khác chỉ nên:
● Tóm tắt;
● Tham chiếu;
● Dẫn người đọc về nguồn chính.
Khi chính sách thay đổi, doanh nghiệp biết đâu là nơi cần cập nhật trước và đâu là các nội dung cần kiểm tra lại.
22. Điều này giúp giảm Content Duplication
Nếu 50 bài đều giải thích đầy đủ cùng một chính sách, doanh nghiệp đang tạo ra 50 bản sao của cùng một Knowledge. Càng nhiều bản sao, càng khó cập nhật và kiểm soát.
Mô hình tốt hơn là xây dựng một Core Knowledge (Tri thức cốt lõi) làm nguồn thông tin chính, sau đó để các nội dung khác tham chiếu và sử dụng lại nguồn này, như Article A, Product B, FAQ C và Sales D.
Đây chính là tư duy Knowledge Reuse (Tái sử dụng tri thức): một nguồn tri thức được sử dụng ở nhiều ngữ cảnh khác nhau thay vì tạo nhiều bản sao.
23. SEO cũng hưởng lợi từ việc xác định URL Ownership rõ ràng
Khi biết URL nào sở hữu Search Intent nào, doanh nghiệp không cần tạo URL mới cho mỗi keyword mà có thể kiểm tra xem đã có URL Owner chưa? Nếu Có: Mở rộng nội dung (Expand); Nếu chưa: Xem xét tạo URL mới.
Đây là cách để hạn chế nhiều URL trong website cùng cạnh tranh một Search Intent.
24. Single Source of Truth không có nghĩa chỉ có một bài về một Topic
Một Topic vẫn có thể có nhiều loại Content. Ví dụ:
● Trang sản phẩm;
● Bài hướng dẫn;
● Bài so sánh;
● Case Study;
● FAQ.
Điều quan trọng là mỗi loại Knowledge cần xác định rõ nguồn chính. Đó là sự khác biệt giữa Content Diversity (Đa dạng nội dung) và Knowledge Duplication (Trùng lặp tri thức).
24. AI Assistant của doanh nghiệp đặc biệt cần Source Hierarchy
Khi có nhiều nguồn thông tin, AI nên ưu tiên nguồn mới và có độ tin cậy cao hơn, theo thứ tự:
• Current Product Database (Cơ sở dữ liệu sản phẩm hiện hành) → ưu tiên cao nhất
• Verified Knowledge Base (Kho tri thức đã xác minh)
• Current Website (Website hiện hành)
• Archived Documents (Tài liệu lưu trữ) → ưu tiên thấp nhất.
Nếu không có Source Hierarchy (thứ tự ưu tiên nguồn), tài liệu cũ có thể được xem ngang hàng với dữ liệu hiện tại. Điều này đặc biệt dễ gây sai lệch khi doanh nghiệp đã tích lũy dữ liệu qua nhiều năm.
25. Digital Memory cần lịch sử, nhưng Single Source of Truth cần trạng thái hiện tại
Hai khái niệm này không mâu thuẫn mà bổ sung cho nhau. Digital Memory giúp doanh nghiệp giữ lại lịch sử, Single Source of Truth giúp xác định phiên bản nào đang có hiệu lực.
Ví dụ:
• 2024: Bảo hành 12 tháng – Archived.
• 2025: Bảo hành 18 tháng – Archived.
• 2026: Bảo hành 24 tháng – Active.
Doanh nghiệp vẫn giữ đầy đủ lịch sử, nhưng hệ thống biết thông tin hiện hành là 24 tháng.
26. Đây chính là Versioned Knowledge (Tri thức có phiên bản)
Thay vì chỉ xác định đúng hay sai, Knowledge cần cho biết “Thông tin này đúng tại thời điểm nào?”. Điều này đặc biệt quan trọng với doanh nghiệp lâu năm. Một tài liệu năm 2018 có thể hoàn toàn đúng vào năm 2018, nhưng không còn đúng nếu áp dụng cho năm 2026.
27. AI càng mạnh, Knowledge Governance càng quan trọng
Khi chưa ứng dụng AI, một file sai có thể chỉ ảnh hưởng đến người mở nó. Nhưng khi AI kết nối với toàn bộ Knowledge Base, thông tin sai có thể được dùng để trả lời rất nhiều người. AI càng mạnh, khả năng khai thác dữ liệu càng lớn. Vì vậy, Data Quality (Chất lượng dữ liệu) cũng càng quan trọng.
Có thể hiểu đơn giản:
Poor Knowledge × Powerful AI → Chưa chắc tạo ra kết quả tốt.
High-Quality Knowledge × Powerful AI → Có thể tạo ra giá trị rất lớn.
28. Góc nhìn từ Trần Lê Group
Trần Lê Group cho rằng khi website và hệ thống Digital Asset của doanh nghiệp phát triển đủ lớn, bài toán không còn chỉ là làm sao tạo thêm Content? Mà còn là: Làm sao đảm bảo toàn bộ hệ thống đang sử dụng cùng một phiên bản tri thức đúng?
Từ đó có thể hình thành một hệ thống tri thức: Single Source of Truth → Structured Knowledge → Knowledge Graph → Digital Memory → Website / Sales / AI → Consistent Customer Experience.
Khi đó, Website, Sales, Customer Service và AI cùng sử dụng một nền tảng tri thức thống nhất, giúp thông tin được nhất quán trên toàn bộ hành trình khách hàng.
29. Sau 10 năm, “sự thật” của doanh nghiệp có thể tồn tại ở hàng nghìn nơi
Một SME ban đầu có thể chỉ có một bảng giá, nhưng sau 10 năm, thông tin giá có thể xuất hiện trong:
● Báo giá;
● Email;
● Website;
● PDF;
● Bài viết;
● Hình ảnh;
● Chatbot.
Nếu không có Source of Truth, mỗi lần thông tin thay đổi đều làm tăng nguy cơ mâu thuẫn và sai lệch. Doanh nghiệp càng phát triển, vấn đề càng rõ. Vì vậy, xây dựng Digital Asset không chỉ là tạo thêm dữ liệu, mà còn là quản trị sự nhất quán của dữ liệu.
30. Kết luận
Ở giai đoạn đầu, doanh nghiệp cần số hóa kiến thức. Sau đó, cần xây Digital Memory để không đánh mất những gì đã tích lũy. Nhưng khi dữ liệu ngày càng lớn, một vấn đề mới xuất hiện: Có quá nhiều phiên bản của cùng một sự thật.
Đây là lúc doanh nghiệp cần tiến thêm một bước: biến dữ liệu thành tri thức có nguồn chuẩn, phiên bản rõ ràng, mối quan hệ được kết nối và có thể phân phối đến đúng nơi sử dụng: Data → Knowledge → Authoritative Source → Version → Relationship → Distribution.
Single Source of Truth không chỉ giúp website chính xác hơn, mà còn giúp:
● Sales tư vấn nhất quán;
● Customer Service trả lời đúng;
● Content dễ bảo trì;
● SEO giảm trùng lặp;
● AI sử dụng dữ liệu đáng tin cậy hơn.
Và quan trọng hơn, nó giúp doanh nghiệp chuyển từ trạng thái “Chúng ta có rất nhiều thông tin.” Sang “Chúng ta biết thông tin nào là đúng, nguồn nào đáng tin và phiên bản nào đang có hiệu lực.”
Trong thời đại AI, lợi thế không chỉ thuộc về doanh nghiệp có nhiều dữ liệu nhất. Nó có thể thuộc về doanh nghiệp tổ chức dữ liệu tốt đến mức con người, website và AI đều biết phải tìm sự thật ở đâu.
ĐT